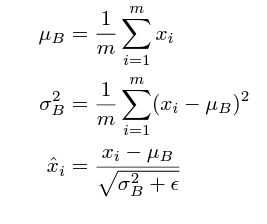최적화(Optimization) 기초

본 강좌에서는 최적화(Optimization) 문제에서 나오는 여러가지 용어들에 대한 명확한 정의와 컨셉만을 집고 넘어간다.
Generalization
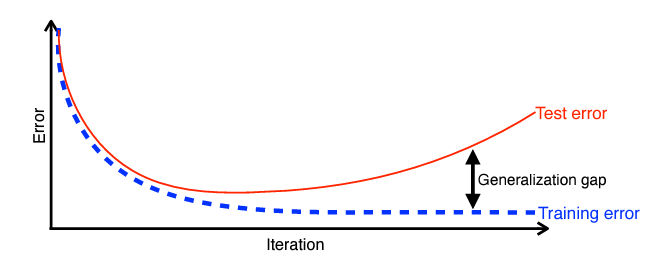
인공지능에서 일반화(Generalization)란 학습된 모델이 unseen data에 대해 얼마나 잘 작동하는지를 의미한다.
- 즉, 일반화 성능(Generalization performence)은 학습 데이터에서의 성능과 테스트 데이터 사이에서의 성능이 얼마나 차이나는지를 말한다.
Underfitting vs. Overfitting
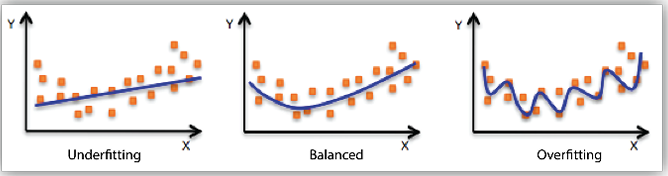
학습 데이터에 대해서 잘 동작을 하지만 테스트 데이터에 대해서 잘 동작하지 않는 현상을 과적합(Overfitting)이라 한다. 반대로, 과소적합(underfitting)은 모델이 너무 단순해서 학습 데이터에서도 잘 동작하지 않는 것을 의미한다.
Cross-validation
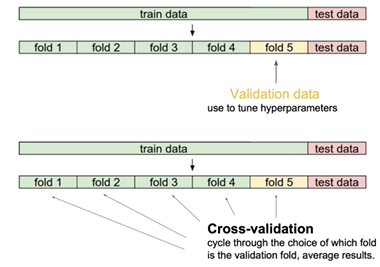
교차 검증(Cross-validation)은 독립적인(테스트) 데이터세트에 대해 얼마나 일반화 성능이 보장되는지를 평가하기 위한 모델 검증 기술이다.
예를들어, 학습 데이터가 10만개가 있다면 2만개씩 5개로 데이터를 분할(partitioning)하고, 1~4까지 partion 데이터를 학습 후 나머지 5 partion 데이터로 validation을 진행한다.
반복 학습의 경우 1,2,3,5 partion 데이터를 학습 후 4 partion 데이터로 validation을 진행한다.
Bias and Variance
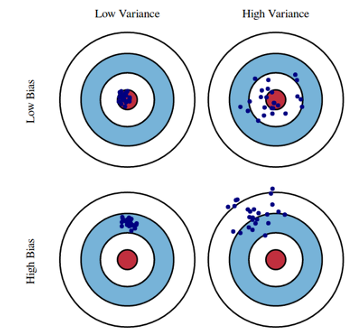
분산(Variance)는 내가 어떤 입력을 넣었을 때 출력이 얼마나 일관적으로 나오는지를 말한다. Bias는 출력이 평균적으로 얼마나 타겟에 멀어졌는가를 말한다.
- 분산이 큰 모델들은 복잡한 모델들이 나오는 만큼 overfitting될 가능성이 크다.
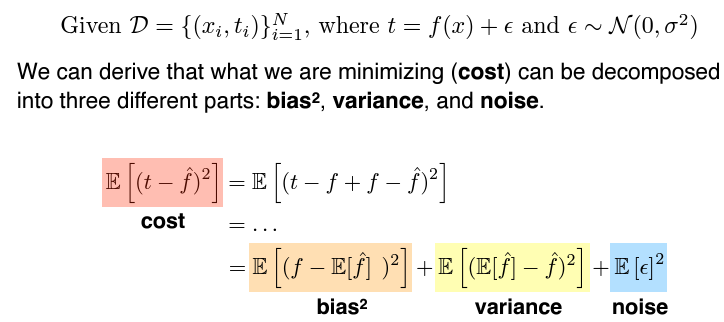
만약 학습 데이터에 noise가 끼어 있다고 가정을 했을 때, $L_2$ 노름 기준으로 최적화를 하게되면 세가지 파트로 나눌 수 있다.
- 즉, 내가 최적화하는 것은 한가지 값인데 사실은 세가지 파트로 이루어져 있어 세개를 각각 최적화 하는 것이 아닌 하나가 줄어들면 하나가 커질 수 밖에 없는 trade-off를 의미한다.
Bootstrapping
Bootstrapping은 만일 학습 데이터가 100개가 있다면 이를 다 사용하는 것이 아닌 일부만을 사용해서 모델을 만들겠다는 것이다. 이렇게 해서 여러개의 모델을 만들어지게 되면 각 모델들의 예측값이 얼마나 일치(consistance)하는지를 보고 모델의 불확실성(uncertainty)를 파악한다.
Bagging vs Boosting
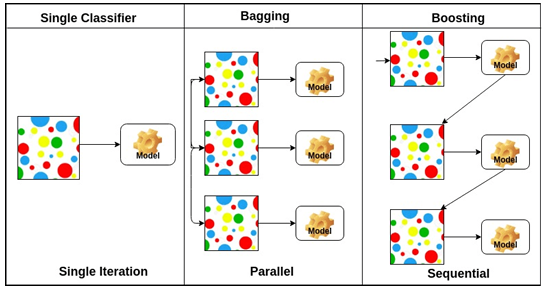
Bagging(Bootstrapping aggregating)은 Bootstrapping을 통해 여러개의 모델을 만들고 나온 모델의 출력 값을 어떤 방식으로든(voting, averaging 등) 평균을 내는 것이다. 이를 앙상블이라고 부르기도 한다.
- n개의 모델을 만들어 출력값의 평균을 내는 것이 한개의 모델을 쓸 때보다 더 좋은 성능이 나올때가 많아 kaggle 같은 대회에서 기본적으로 활용하는 테크닉이다.
Boosting은 만일 학습 데이터가 100개가 있다면 간단하게 모델 하나를 만들고 결과를 분석하여 두번째 모델에는 이를 sequential하게 반영(잘못 동작한 데이터에 잘 작동하는 모델을 만들기 등)하는 기법이다.
Batch-size Matters
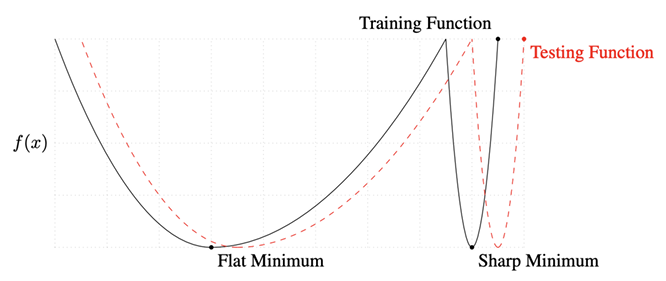
해당 논문(On Large-batch Training for Deep Learning: Generalization Gap and Sharp Minima, 2017)에 따르면 large batch-size(512, 124 등)를 사용하면 sharp minimizers에 도달하고 small batch-size를 사용하면 flat minimizers에 도달한다고 한다.
- 논문에서는 flat minimizer가 더 좋다고 하는데 그 이유는 sharp minimizer의 경우 약간만 떨어지게 되어도 sharp minimum에 도달하지 못할 수 있다는 것이다.
Gradient Descent Methods
가장 기본적인 Gradient descent는 $W_{t+1} \leftarrow W_t - \eta g_t$로 $\eta$는 learning rate, $g_t$는 gradient를 의미한다.
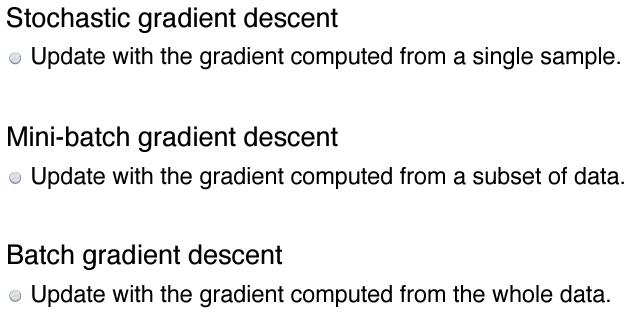
Gradient descent의 가장 큰 문제는 learning rate 혹은 step-size를 결정하는 것이 어렵다는 것이다. 이에 더 빨리 효율적으로 학습시키기 위한 optimization technique이 발전하게 된다.
그 중 Momentum은 한번 gradient가 흘렀던 방향으로 관성을 유지시키기 위한 방법이다.
기존
$g_t$텀을 accumulation ($a_{t+1}$) 텀으로 교체했다.$a_{t+1}$는$\beta$라는 momentum이 하이퍼 파라미터가 추가되어 이전 gradient를 얼마나 기억할지 결정한다.
$$a_{t+1} \leftarrow \beta a_t + g_t \\ W_{t+1} \leftarrow W_t - \eta a_t$$
즉, Momentum은 현재 주어져 있는 파라미터에서 gradient를 계산해서 그 gradient를 accumulation 하는 방식이다. 이와 다르게 NAG(Nesterov Accelerated Gradient)는 $a_t$라는 현재 정보가 있으면 그 방향으로 한번 가보고 간 곳에서 gradient를 계산한 후 accumulation 한다.
- 예를들어, local minimum의 왼쪽 slop에서 gradient로 인해 오른쪽 slop으로 이동했을 때 momentum은 local minimum 방향이 아니라 계속 오른쪽 방향으로 이동할 수 있는 반면 NAG는 local minimum 쪽으로 이동할 수 있다.
$$a_{t+1} \leftarrow \beta a_t + \nabla(W_t - \eta \beta a_t) \\ W_{t+1} \leftarrow W_t - \eta a_t$$
지금까지는 방향성 관련된 optimization techinque이었다면 모델 파라미터 측면에서도 optimization techinque이 발전하게 된다.
Adagrad는 지금까지 많이 변한 어떤 파라미터들에 대해서는 적게 변화시키고 안변한 파라미터들에 대해서는 많이 변환시키는 방법이다.
- 지금까지 파라미터가 얼만큼 변했는지를 저장하는 값이
$G_t$로 제곱의 합으로 계산한다. 이를 분모로 넣었기 때문에 값이 커질수록 적게 업데이트 되도록 한 것이다.
$$W_{t+1} \leftarrow W_t - \frac{\eta}{\sqrt{G_t} + \epsilon} g_t$$
Adagrad의 문제는 분모가 무수히 커지면서 계산이 불가능해지는 경우이다. 이를 방지하기 위해 Adadelta라는 방법론이 나온다.
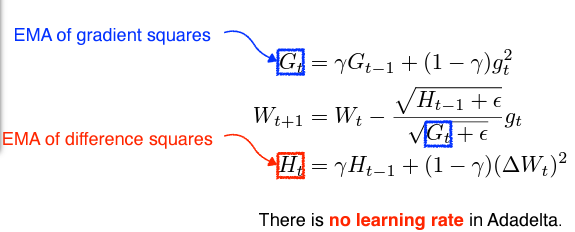
Adadelta는 현재 타임 t에서 window size 시간만큼의 파라미터의 변화만을 보는 방법이다.
window size 만큼의 파라미터들을 계속 저장하고 있어야해서 마찬가지로 메모리 문제가 발생하게 되는데 이걸 방지하기 위해 EMA를 사용한다.
Adadelta는 바꿀 수 있는 하이퍼 파라미터가 많지 않아 지금은 거의 활용되지 않는다.
RMSprop는 논문이 아닌 Geoff Hinton 교수님이 강의시간에서 제안한 방법론으로 $G_t$를 그냥 더하는게 아니라 EMA을 통해 더하는 것이다.
$$G_t = \lambda G_{t-1} + (1-\lambda)g_t^2 \\ W_{t+1} \leftarrow W_t - \frac{\eta}{\sqrt{G_t} + \epsilon} g_t$$
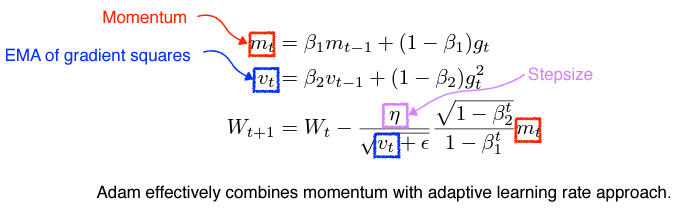
Adam(Adaptive Moment Estimation)은 $G_t$를 EMA로 가져가는 동시에 momentum을 같이 활용 방법이다.
Regularization
학습에 규제를 걸어 학습 데이터에서만 잘 동작하는 것이 아니라 데스트 데이터에서도 잘 동작해주도록 만드는 방법론이 Regularization이다.
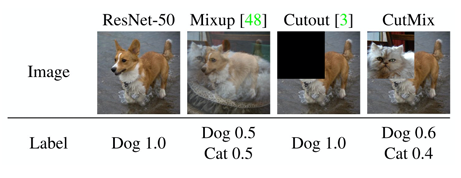
Label Smoothing이라는 것은 학습 데이터 두개를 뽑아서 섞어주는 것을 의미한다.
그 중 Mix-up 방법은 무작위로 선택된 두 훈련 데이터의 입력과 출력을 모두 혼합하여 학습 데이터를 구성하는 것이다.
CutMix는 입력을 잘라서 붙여넣고 출력을 무작위로 선택된 두 훈련 데이터의 소프트 라벨과 혼합하여 학습 데이터를 구성하는 것이다.
Batch Normazliation은 적용하고자 하는 레이어의 statistic을 정규화하는 것이다.
- 해당 파라미터의 각각의 값들을 정규화하는 것이다.